Namenskonventionen
-
Entwicklungcode → Build → Release: ein Buildprozess erstellt eine lauffähige Lösungsversion, diese wird (bei Erfolg) als Release gespeichert.
-
Paketierung: Die Paketierung setzt aus Releases ein größeres Lösungspaket zusammen.
-
Publish: Bereitstellung zum öffentlichen Download
-
Deployment: Auslieferung an einen Kunden durch Erzeugung einer verwendbaren Instanz der Lösung
Logging
-
Jedes Gateway loggt seinen Output für die Ausgabe nach OCT (Konsolehander) ggf. auch für die Ausgabe als Datei (Dateihandler) wie hier beschrieben: Logging in Gateways ab OCT Version 2026.02.
Funktionsprinzip
Das Gateway - 5 Prinzipien im Überblick …
-
schafft sich seine Tabellen in der staging Schicht.
-
erstellt sich eine Pipeline für seinen Ladeprozess.
-
erstellt sich eine Productline in der Validierungsfactory für die Validierung seiner Rohdaten.
-
erstellt sich eine Productline in der Datenanalyse Factory, um seine Daten analysieren zu lassen.
-
erstellt einen Step in der Truncate Pipeline, um seine Daten löschen zu können.
Gateway übergreifende Regeln
-
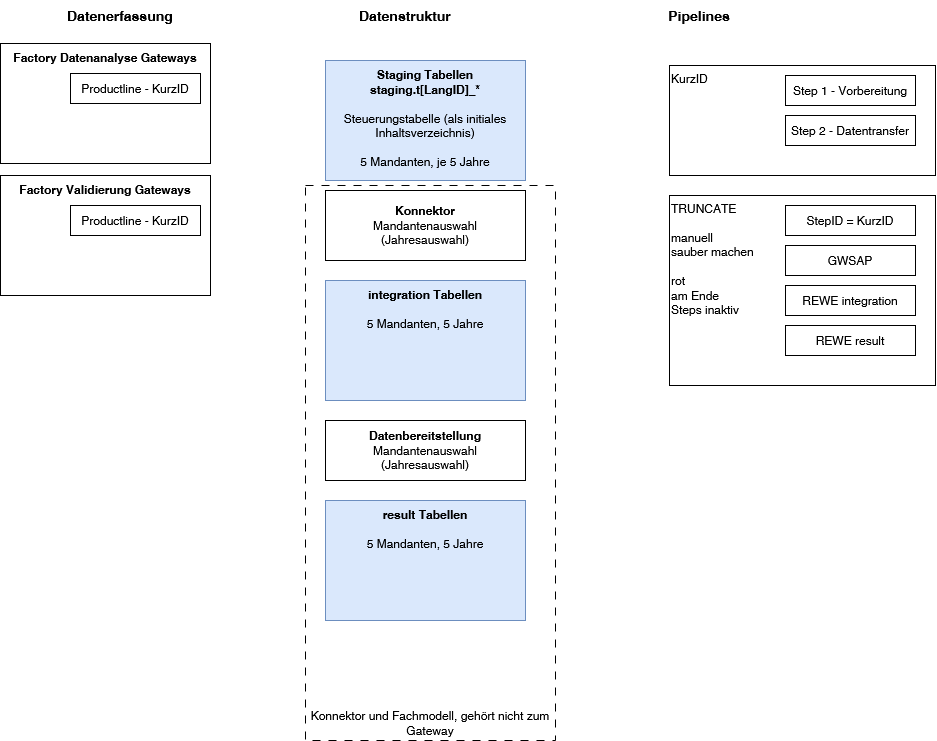
Mehrere Gateways sollen sich ohne Konflikte in eine einzige OCT Datenbank einspielen lassen. → Gateways müssen sich daher an diesen Standard halten.
-
Jedes Gateway legt seine Datenbankobjekte im Schema staging ab.
-
Das staging Schema sollte darauf ausgelegt sein, Daten aus mehreren DatenquellenIDs dieses Gateways zu speichern - durch eine führende Spalte DatenquellenID in jeder staging Tabelle.
-
Jede Gateway besitzt eine ID in Kurzform und Langform - z.B. bei DATEVconnnect
-
KurzID = GWDC
-
LangID = DATEVCONNECT
-
-
Jedes Gateway nutzt seine LangID, welche es allen Datenbankobjekten im Namen voranstellt, z.B. staging.tDATEVCONNECT_xxx.
-
Jedes Gateway legt sich eine Pipeline an, welche als PipelineID die KurzID nutzt.
-
Für Anleitungen, für Updates etc. soll die ID referenziert werden können.
-
-
Probleme:
-
Eineindeutigkeit muss über alle Systeme möglich sein.
-
Pipeline kann sehr einfach überschrieben werden. Ein erneutes Einspielen zerstört die Pipeline.
-
Bezeichnungsnot bei mehreren Datenquellen bzw. mehreren Pipelines vom gleichen Typ.
-
allein manuelle oder ausführliche Ausführung des SAP-Steps müssten eigentlich die gleiche ID haben, benötigt Nummerierung bzw. Erweiterung der Benennung
-
-
-
eine Factory “Validierung Gateways (VGW)” existiert bzw. das Gateway legt diese an, aber ohne DELETE
-
in dieser Factory legt jedes Gateway eine eigene Productline mit seiner KurzID an, z.B. “Validierung Gateway DATEVconnect (GWDC)” für die technische Validierung seiner Daten
-
Anzahl der Zeilen pro Tabelle und Mandant als Pivotauswertung
-
Top 1000 Zeilen pro Tabelle als Preview
-
Pivotauswertungen, sofern diese auf den Rohdaten möglich sind
-
-
optional: eine Factory “Datenanalyse Gateways (DAG)” existiert
-
in der Factory legt sich jedes Gateway eine Productline mit seiner KurzID an, “Datenanalyse Gateway DATEVconnect (GWDC)” für den fachlichen Konsum der Daten
-
Fakten gejoint mit Dimensionen und ggf. Aggregation zur Ansicht in OCT
-
-
Geteilte Pipeline für die Nutzung durch Gateways / Konnektoren / Module
-
Es soll in der Datenbank eine einzige Pipeline “TRUNCATE - OCT Datenbank leeren” geben, in welche jedes Gateway die TRUNCATE Befehle für seine Tabellen als ein Step einfügt.
-
-
Das Gateway legt sich globale Parameter mit der KurzID als Präfix an, z.B. “GWDC_DatenquellenID” (umgesetzt, außer bei DATEV)
-
Das Gateway darf keine Content-Elemente von OCT.CORE löschen.
Globale Komponenten
-
In der Datenbank gibt es eine Factory “Technische Validierung (VT)”, in der sich global funktionsfähige Validierungsübersichten befinden.
-
Größe der Datenbank insgesamt und Zeilenzahl insgesamt → globale Kennzahl “Durchschnittlicher Speicherplatz pro Tabellenzeile in der Datenbank”
-
Größe und Zeilenzahl jeder Tabelle der Datenbank → Tabellenkennzahl “Durchschnittlicher Speicherplatz pro Zeile” für jede Tabelle
-
Parameterprodukt “Warnindikatoren”
-
Datenbankgröße
-
-
-
Eine Pipeline “DBMONITOR” vermisst täglich die Datenbank und schreibt die Kennzahl in eine Monitoringtabelle.
-
Größe der DB
-
Zeilenzahl
-
Ein E-Mail-Step am Ende sendet eine E-Mail, falls ein Wert über einem Warnindikator liegt.
-
-
Eine Auswertung berechnet Kennzahlen und visualisiert diese.
-
Datenbankgröße
-
Zeilenzahl
-
Wachstumsrate der Tabellengröße in %
-
Wachstumsrate der Zeilenzahl in %
-
Regeln für das einzelne Gateway
-
IDs für Pipelines - jedes Gateway erstellt eine Pipeline mit seiner KurzID (somit werden keine zufällig vergebenen Nummern für Pipelines genutzt).
-
Steps in der Pipeline erhalten die ID “KurzID[Nr]”
-
In der globalen Pipeline TRUNCATE wird ein Step für das Gateway mit der KurzID des Gateways eingefügt.
-
Farbcodes für die Pipelines - Pipelines erhalten Farbcode
-
grün für Pipelines, welche üblicherweise periodisch und ohne Nebenwirkungen ausgeführt werden (#089944)
-
orange für Management Pipelines (#f5b916)
-
rot für gefährliche Pipelines, bspw. die TRUNCATE Pipeline (#f23f23)
-
-
Das Gateway unterstützt die Ausführung über Container oder on-premises durch mehrere Stepvarianten.
-
Notwendige Parameter für Skripte werden in einer config Datei abgelegt, nicht hart in das Skript codiert.
-
Die config Datei wird vom Skript validiert, ob die dortigen Parameterwerte zusammenpassen (gültige URL, WinAuth 0/1 passend zu User / Passwort etc.)
-
Kombinationsfähigkeit
-
Das Gateway soll in einen Fachmodelprozess eingebaut werden können - dieser umfasst meist Gateway - Konnektor - Fachmodell.
-
Man soll Gateway - Konnektor - Fachmodell einzeln oder als Komplettpaket einspielen können.
-
Alle Gatewaykomponenten (insbesondere Productlines / Pipelines / Steps) müssen daher eindeutig adressierbar sein.
-
-
Ein Release veröffentlicht neben den zu einem Skript konkatenierten Datenbankobjekten auch die Einzelkomponenten.
Versionierung
-
Derzeit Versionierung über OCTBox Nummer
-
später: Versionierung des Gateways als Gesamtpaket
-
Jedes Release eines Gateways erhält eine Versionsnummer gemäß den Regeln des Semantic Versioning oder alternativ des Calendar Versioning.
-
Die jeweilige Versionsnummer ist im Setup-Ordner in der Datei „version.txt“ hinterlegt.
-
Die Versionsnummer des Gateways wird in der Datenbank gespeichert: Name = [LangID]_VERSION mit Textwert, z.B.
-
SettingID = GATEWAY_DATEVCONNECT_VERSION
-
ValueText = 2026.04.10
-
-
Die Versionnummer wird in der Validierungsoberfläche des Gateways gezeigt.
-
Für jedes Gateway wird ein Releaselog im öffentlichen Help Center geführt.
-
Jedes veröffentlichte Release enthält im Releaselog eine Übersicht der Änderungen gegenüber der vorherigen Version, unterteilt in Features, Fixes und Modifikationen.
-
-
später: Versionierung interner Komponenten
-
Das Gateway wird zusammen mit einer Konfigurationsdatei („config.json“) verwendet. Bei Updates wird diese Datei in der Regel übernommen.
-
Um die Kompatibilität sicherzustellen, prüft das Gateway, ob die verwendete Konfigurationsdatei zur jeweiligen Version passt.
-
Zu diesem Zweck enthält die „config.json“ eine Property „config_version“, in der die Version des Gateways als String gespeichert ist.
-
Konnektoren für Gateways
-
PipelineID = Kurz_ID_[Zielmodell] - z.B. GWDC_REWE
-
Steps erhalten auch diese ID mit laufender Nummer.
Fachmodellregeln
-
Jedes Fachmodell legt sich eine Factory mit seiner KurzID an, z.B. “Fachmodell REWE (REWE)”. Diese besitzt eine vom Fachmodell definierte Productlinestruktur.
-
Jedes Fachmodell legt sich Pipelines mit seiner KurzID an.
Paketregeln
-
Ein Paket aus Gateway - Konnektor - Fachmodell unterscheidet sich im Bereich der Datenerfassung nicht von einzeln eingespielten Komponenten.
-
Das Paket erstellt eine kombinierte Pipeline aus den Einzelpipelines der Komponenten mit dem Namen “RUNME” - sofern mehrere Pakete in einer Datenbank laufen, wird diese Pipeline auf eine andere ID verschoben (via Export / Import, da momentan noch nicht direkt möglich).
Anpassung von Stagingdaten
In den staging Tabellen können, neben den gespiegelten Spalten, OCT_* Spalten existieren, die von OCT ermittelt werden. Diese sind relevant, falls schon die Stagingdaten bearbeitet werden müssen für
-
Datenquellenunterscheidung
-
Kennzeichnung
-
Historisierung
-
Vorsystemspezifische AddOns (Kontenverteilungen)
-
Konsum direkt auf Gatewayebene
-
Validierbarkeit auf Stagingebene